Hvorfor AI-dokumentarbeidsflyter sliter med å skalere uten kontekst
Hvorfor AI-dokumentarbeidsflyter sliter med å skalere uten kontekst
Bygge en enkel AI-drevet dokumentarbeidsflyt
De fleste organisasjoner kan bygge en grunnleggende AI-dokumentarbeidsflyt. Systemet registrerer et dokument, trekker ut dataene, utløser en arbeidsflyt, og oppgavene går videre derfra.
I liten skala fungerer dette bra. Tidlige resultater viser ofte at manuell innsats reduseres, behandlingshastighetene forbedres, og team begynner å se hva automatisering kan gjøre. Men når arbeidsflyter utvides utover isolerte brukstilfeller, viser begrensningene seg raskt.
Unntak hoper seg opp, og rutingen blir inkonsekvent. AI-utdata må valideres før noen stoler på dem, og team ender opp med å stole på manuell inngripen bare for å holde ting i gang. Det som så ut som en skalerbar løsning begynner å introdusere ny driftsfriksjon i stedet for å fjerne den. Problemet er ikke konseptet med en AI-drevet arbeidsflyt. Det er hva arbeidsflyten mangler.
Det er her en dokumenthåndteringsplattform som M-Files , som fokuserer på dokumentets kontekst, endrer ligningen. I stedet for å behandle et dokument som en isolert fil som skal rutes gjennom trinn, M-Files klassifiserer og beriker automatisk hvert dokument med metadata og relasjoner, og kobler det til leverandørene, klientene, prosjektene og kontraktene det tilhører fra det øyeblikket det registreres. Denne metadatadrevne konteksten er det som holder en arbeidsflyt pålitelig når den skaleres, og det er gapet dette innlegget graver i.
Arbeidsflyter uten kontekst blir skjøre
De fleste arbeidsflyter for dokumentbehandling basert på kunstig intelligens er bygget opp rundt trinn. Et dokument beveger seg fra ett trinn til det neste basert på forhåndsdefinerte regler, vanligvis utløst av utvunnede data, dokumentklassifisering eller manuell brukerinndata. Denne modellen antar at systemet har nok informasjon til å ta nøyaktige beslutninger i hvert trinn. I virkeligheten har det ikke det.
Et dokument er mer enn en fil som beveger seg gjennom en prosess. Det representerer noe i virksomheten, og det kan være knyttet til en leverandør, en klient, et prosjekt, en kontrakt, en faktura, som inneholder PII-data eller et regulatorisk krav. Betydningen kommer fra disse relasjonene, og når disse relasjonene ikke fanges opp eksplisitt, er arbeidsflyter avhengige av antagelser, og prosessene bryter sammen.
Etter hvert som kompleksiteten øker, blir arbeidsflyter skjøre. Rutebeslutninger krever menneskelig tolkning, unntak krever manuell løsning, og AI-utdata kan ikke stoles på uten verifisering fordi systemet mangler konteksten som er nødvendig for å forstå dokumentets rolle. Arbeidsflyten fortsetter å fungere, men ikke pålitelig.
Hvorfor AI alene ikke kan løse kompleksiteten i arbeidsflyten
AI har forbedret måten organisasjoner behandler dokumenter på betraktelig. Den kan trekke ut strukturerte data, klassifisere dokumenter og utløse handlinger med økende nøyaktighet, og disse funksjonene er verdifulle, spesielt for å redusere manuell innsats ved dokumentinntak. Imidlertid løser ikke AI alene det bredere problemet med kompleksitet i arbeidsflyten.
Uttrekking svarer på spørsmålet: Hva sier dette dokumentet? Arbeidsflyter krever svar på forskjellige spørsmål:
- Hva er dette dokumentet i forretningssammenheng?
- Hvilken prosess tilhører den?
- Hvilke regler gjelder for det?
- Hva bør skje videre?
Dette er ikke spørsmål på innholdsnivå. De er spørsmål på kontekstnivå. Uten en konsekvent måte å fange opp og anvende kontekst på, forblir arbeidsflyter avhengige av at folk tolker dokumenter og veileder beslutninger, noe som begrenser skalerbarhet og introduserer variasjon. AI kan akselerere individuelle trinn i automatisering av dokumentarbeidsflyt , men den kan ikke sikre at den overordnede prosessen fungerer med klarhet og konsistens.
Overgangen fra trinnbaserte arbeidsflyter til kontekstdrevne arbeidsflyter
For å bygge arbeidsflyter som kan skaleres, må organisasjoner tenke nytt om hvordan arbeidsflyter er strukturert. Tradisjonelle arbeidsflyter er trinnbaserte: de definerer en sekvens av handlinger og er avhengige av regler for å flytte dokumenter fra ett trinn til det neste. Kontekstdrevne arbeidsflyter har en annen tilnærming, og fokuserer på relasjoner i stedet for trinn.
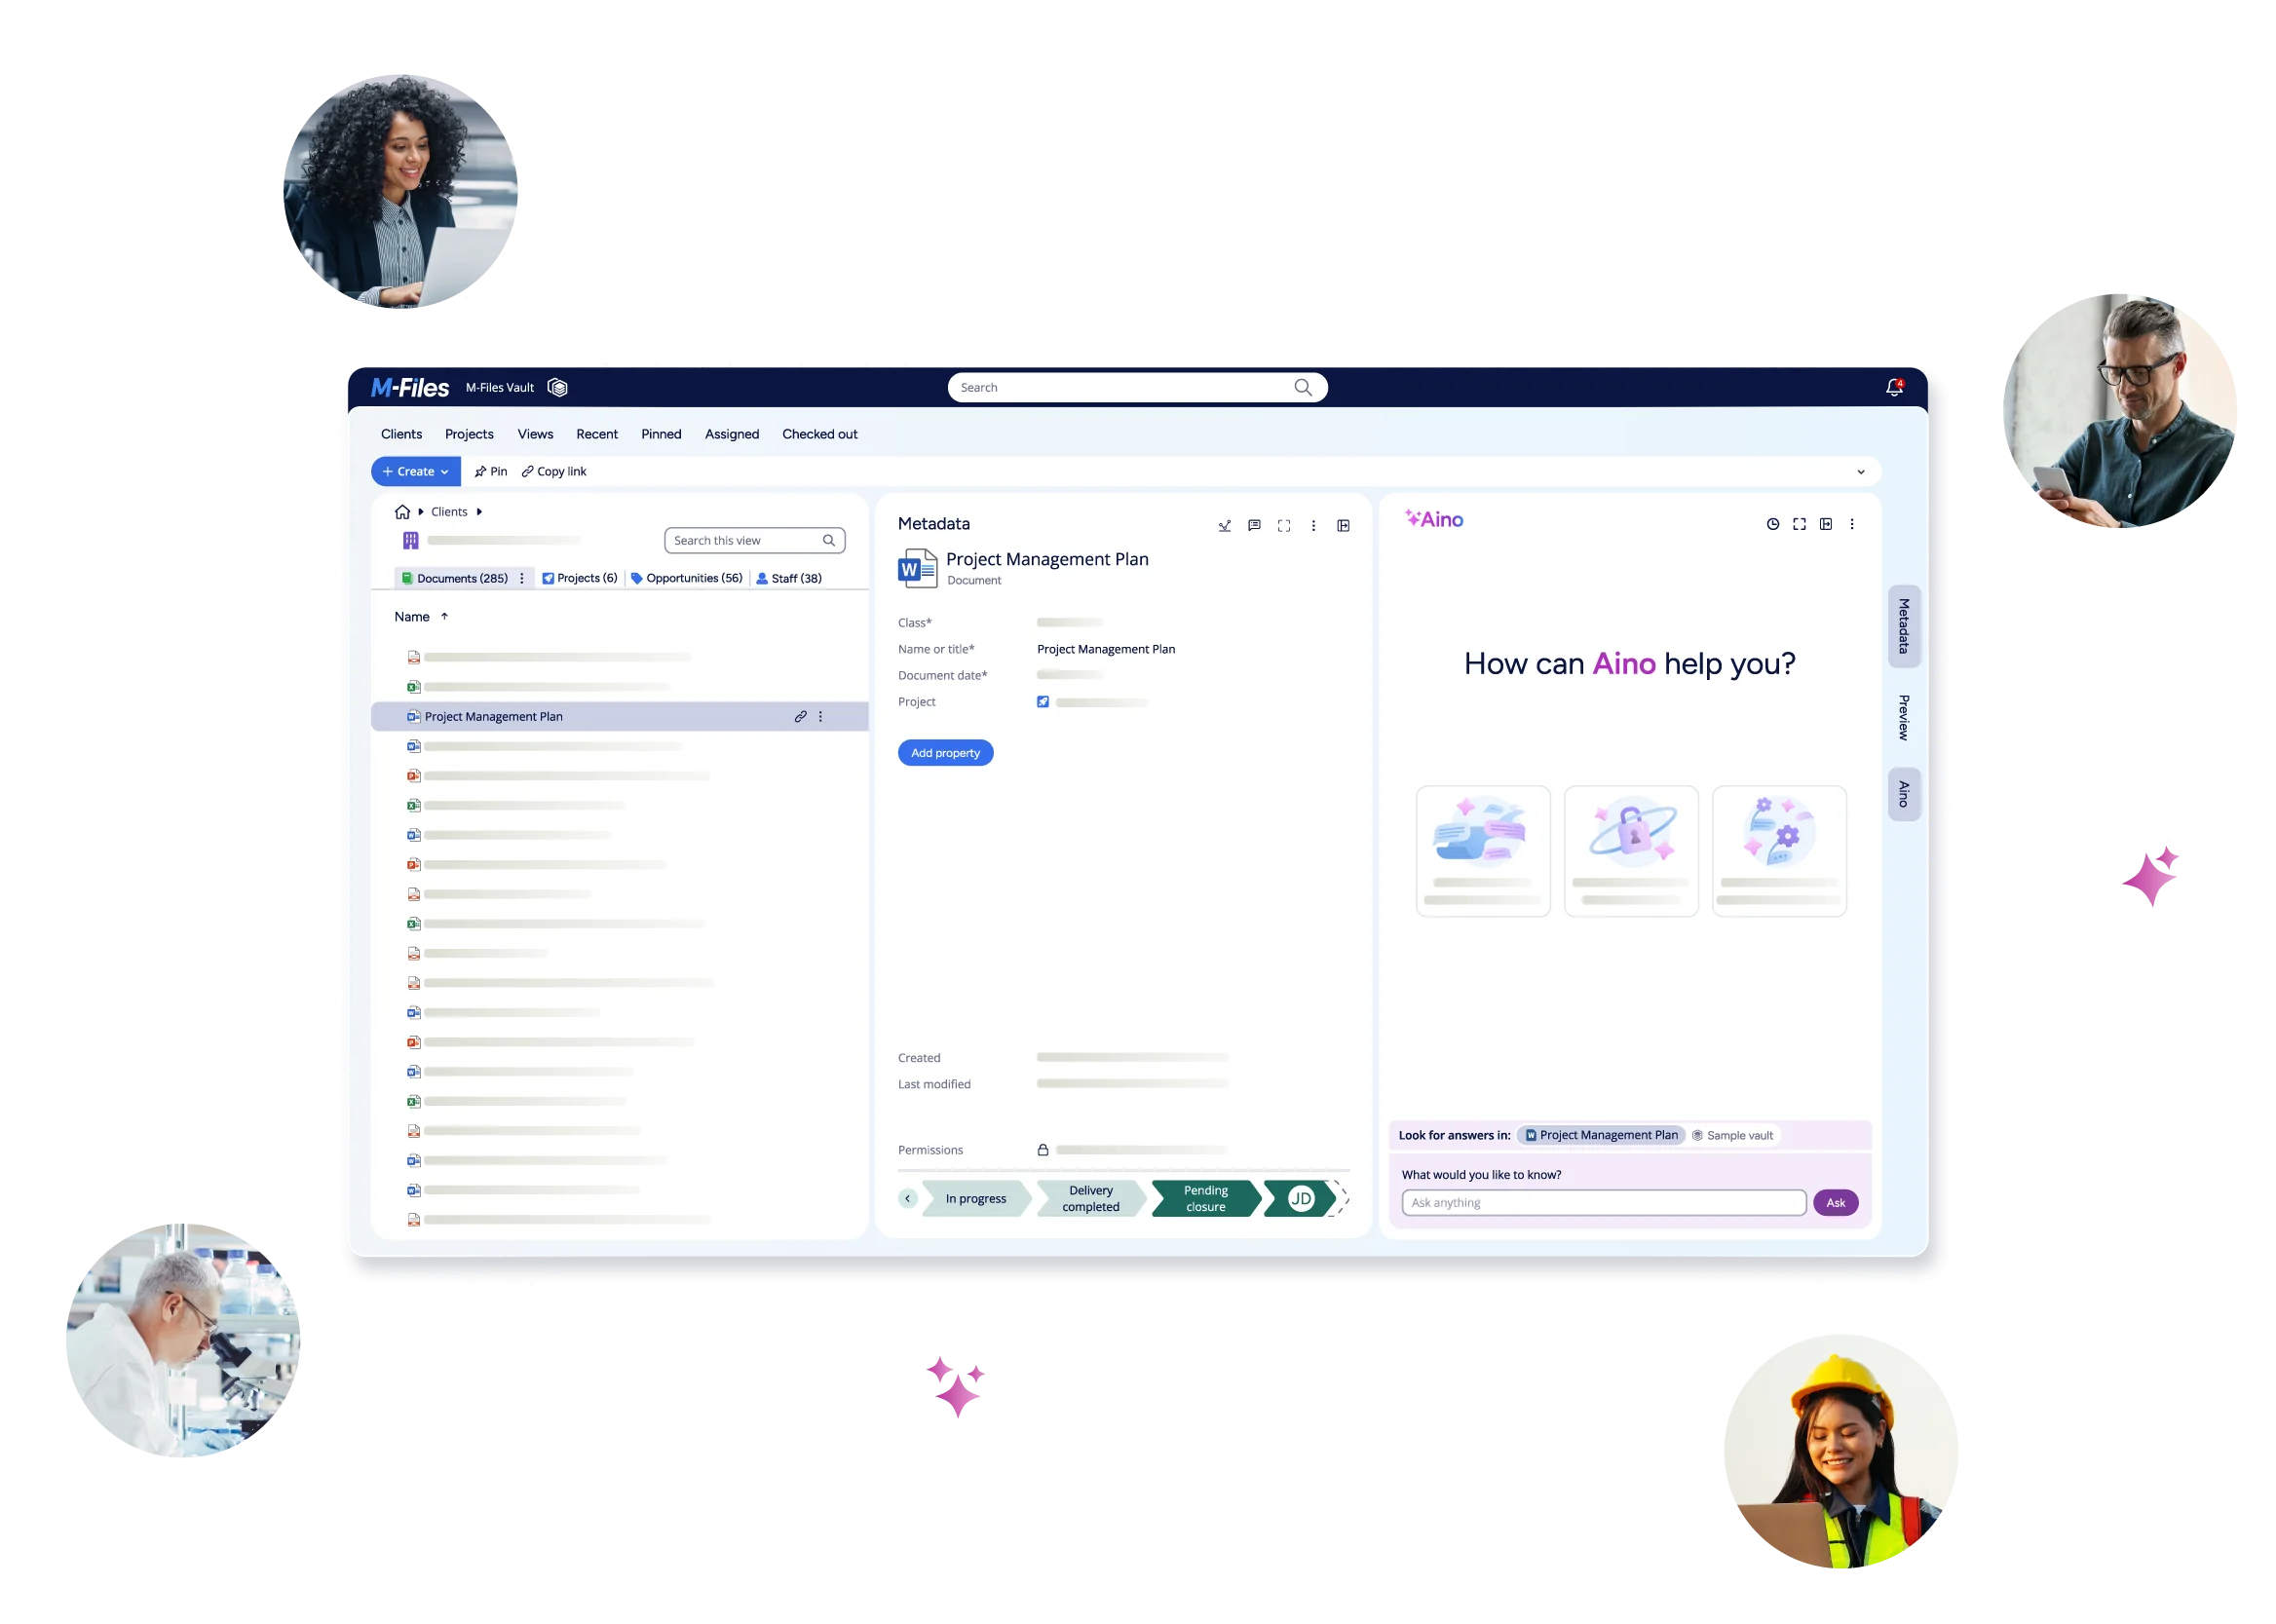
I kontekstdrevne arbeidsflyter er dokumenter koblet til enhetene de er relatert til: kunder, leverandører, prosjekter, kontrakter og prosesser. M-Files fanger opp disse relasjonene som strukturerte metadata og vedlikeholder dem gjennom hele dokumentets livssyklus. Dette gjør at dokumenthåndteringssystemet ditt kan forstå hva et dokument er og hvordan det passer inn i virksomheten din.
Når denne forståelsen finnes, blir arbeidsflyter mer dynamiske. Rutebeslutninger er basert på eierskap og relasjoner snarere enn statiske regler, unntak identifiseres gjennom inkonsekvenser i kontekst snarere enn forhåndsdefinerte betingelser, og systemet tildeler godkjenninger automatisk basert på ansvar. Arbeidsflyten tilpasser seg fordi systemet forstår arbeidet. Det er grunnlaget for intelligente dokumentarbeidsflyter: automatisering som justerer seg fordi den forstår kontekst, ikke fordi den følger en fast regel.
Et praktisk eksempel: Fakturabehandling
Forskjellen mellom disse tilnærmingene blir tydelig når de brukes på en vanlig prosess som fakturahåndtering. I en tradisjonell AI-drevet arbeidsflyt behandles en faktura basert på utvunnede data, og godkjenningsbaner bestemmes av regler knyttet til felt som beløp eller leverandør. Når fakturaen ikke samsvarer med disse reglene, krever prosessen manuell inngripen.
I en kontekstdrevet arbeidsflyt, M-Files kobler umiddelbart fakturaen til leverandøren, kontrakten, prosjektet og kostnadssenteret den tilhører, og disse relasjonene gir konteksten som trengs for å veilede arbeidsflyten. M-Files ruter godkjenninger automatisk basert på eierskap, bruker tilpassede agenter til å sjekke fakturaen mot kontraktsvilkår og flagge unntak for gjennomgang, og anvender styring konsekvent fordi systemet forstår hva dokumentet representerer. Arbeidsflyten går ikke bare raskere. Den blir mer pålitelig og mindre avhengig av manuell tilsyn.
Hvorfor kontekst muliggjør skalerbare arbeidsflyter
Etter hvert som arbeidsflyter utvides på tvers av en organisasjon, blir konsistens stadig viktigere, og kontekst sørger for denne konsistensen. Når kontekst fanges opp automatisk og brukes jevnt, kan arbeidsflyter operere på tvers av avdelinger, systemer og brukstilfeller uten at det kreves konstant redesign.
Kontekstorientert dokumenthåndtering gir bedriften din flere viktige fordeler:
- Reduserer operasjonell friksjon: team bruker mindre tid på å tolke dokumenter og løse unntak.
- Forbedrer beslutningskvaliteten: Dokumenter evalueres i hele virksomhetens kontekst, noe som reduserer sannsynligheten for feil.
- Muliggjør mer effektiv automatisering av dokumentarbeidsflyt basert på kunstig intelligens: Kunstig intelligens-systemer kan stole på strukturerte relasjoner i stedet for å prøve å utlede mening fra innhold alene.
Sammen tillater disse fordelene M-Files for å hjelpe arbeidsflytene dine med å skalere uten å øke kompleksiteten.
Fra automatisering til forståelse
Utviklingen av dokumentarbeidsflyter handler ikke bare om økt automatisering. Det handler om å forbedre forståelsen. Automatisering fokuserer på å utføre forhåndsdefinerte oppgaver mer effektivt, mens forståelse gjør det mulig for systemer å ta bedre beslutninger, og kontekst er det som bygger bro over dette gapet.
Ved å bygge inn kontekst i grunnlaget for dokumenthåndtering, skaper organisasjoner arbeidsflyter som ikke bare er raskere, men også mer nøyaktige, tilpasningsdyktige og pålitelige. Dette gjør at AI kan bevege seg utover isolerte brukstilfeller og bli en sentral del av hvordan arbeidet utføres.
Gjør kontekstdrevne arbeidsflyter virkelige med M-Files
Kontekstbasert dokumenthåndtering danner grunnlaget for å bygge disse arbeidsflytene. M-Files er et kontekstorientert dokumenthåndteringssystem som er bygget for å gjøre dette mulig. I stedet for å organisere dokumenter etter plassering, M-Files organiserer dem basert på hva de er og hvordan de relaterer seg til virksomheten, ved hjelp av en kunnskapsgraf for bedrifter som kobler dokumenter til personene, prosjektene og systemene de tilhører, og denne konteksten fanges opp kontinuerlig og brukes konsekvent.
Arbeidsflyter i M-Files er drevet av denne konteksten. M-Files ruter dokumenter, tildeler godkjenninger og anvender styring basert på relasjoner i stedet for statiske regler, og Custom Agents utvider dette ytterligere ved å automatisere vurderingsbaserte trinn , som å sjekke en faktura mot kontraktsvilkår før den rutes til godkjenning. M-Files AI opererer på den samme strukturerte, pålitelige informasjonen, slik at resultatene er mer pålitelige og enklere å forklare. Fordi M-Files er innebygd i Microsoft 365 , kobles disse kontekstdrevne arbeidsflytene direkte til Teams, SharePoint og Copilot , slik at team kan ta dem i bruk uten å måtte forlate verktøyene de allerede bruker.
Kontekst er forskjellen
Dokumentarbeidsflyter med kunstig intelligens feiler ikke fordi de mangler automatisering. De feiler fordi de mangler kontekst. Når kontekst er innebygd i dokumenthåndtering, blir arbeidsflyter mer tilpasningsdyktige, mer pålitelige og enklere å skalere, og kunstig intelligens blir mer effektiv. M-Files gjør dette mulig, ved å fange opp konteksten automatisk gjennom metadata, relasjoner og strukturerte arbeidsflyter, slik at AI opererer innenfor et strukturert miljø som gjenspeiler hvordan virksomheten faktisk fungerer. Dette gjør det mulig for organisasjoner å gå fra isolert automatisering til vedvarende ytelsesforbedring med M-Files .
Klar til å oppdage kraften i M-Files Bestill en demonstrasjon nå.
Nyeste artikler
Utforsk temaer
Ressurser
Se M-Files